NVIDIA PAIR 사용법: 첫 AI 요청부터 처리한 PC 확인까지
PAIR 1.0.0과 Ollama로 입력·응답 파일을 만들고 Jobs에서 실행 PC를 확인해요. 공식 문서 기반 단계별 안내예요.
마지막 업데이트
메뉴나 지원 기능이 달라졌다면 아래 자료 확인일과 현재 앱 버전을 함께 봐주세요.
이번 목표는 PAIR로 짧은 AI 요청 하나를 보내고, 응답 파일과 실제 처리한 PC를 함께 확인하는 것이에요. v1.0.0 공식 사용 설명서를 바탕으로 만든 따라 하기예요. 범블비가 설치나 추론을 직접 실행한 기록은 없으므로 아래 출력은 예상 결과로 읽어주세요. 앱의 역할부터 알고 싶다면 PAIR 소개를 먼저 보면 좋아요.
시작하기 전에 준비해요
PAIR를 설치할 컴퓨터 한 대, 모델을 받을 인터넷 연결과 저장 공간, 모델을 실행할 수 있는 메모리가 필요해요. 두 PC 간 전달까지 확인하려면 같은 신뢰할 수 있는 로컬 네트워크에 두 번째 PC도 준비해요. 처음에는 한 대의 연결을 확인한 뒤 두 번째 PC를 추가하면 어느 단계에서 막혔는지 구분하기 쉬워요. 앱 버전은 두 PC 모두 1.0.0으로 맞추고, 엔진 버전과 모델 이름은 실제 설치한 값을 기록해주세요.
예시는 Ollama 엔진과 OpenAI 호환 요청 형식을 사용해요. 이 형식은 OpenAI의 유료 모델을 호출한다는 뜻이 아니라, 로컬 모델에 보내는 메시지의 구조예요. 엔진과 모델의 이용 조건·기기 요구 사항은 각 문서도 확인해야 해요. 아직 모델이 없다면 아래 Add model 단계에서 내려받을 수 있어요.
1. 운영체제에 맞는 PAIR를 설치해요
공식 v1.0.0 릴리스에서 운영체제와 CPU 구조에 맞는 설치 파일을 고르세요. Windows x64 예시는 NVPAIR-Setup-1.0.0-x64.exe예요. macOS는 디스크 이미지를 열어 NVIDIA PAIR를 Applications에 넣고, Debian 계열 Linux는 해당 .deb 패키지를 설치해요. 서비스만 들어 있는 압축 파일은 일반 데스크톱 설치 파일과 구분해주세요.
앱을 열면 초기 설정 창에서 설치할 엔진을 선택할 수 있어요. 이 글에서는 Ollama 하나를 준비하면 돼요. 초기 설정을 끝낸 뒤 Overview에 내 PC 카드가 표시되는지 봐주세요. Loading…에서 계속 멈춘다면 먼저 Settings → Service에서 서비스 상태를 확인해요. 모델 다운로드나 PC 연결로 넘어가기 전에 앱의 기본 서비스가 준비돼야 해요.
2. 엔진을 시작하고 모델을 준비해요
Overview → 내 PC 카드 → Engine settings를 열어 Ollama의 설치 여부를 확인하고 실행 스위치를 켜요. 엔진을 펼친 다음 Add model에서 기기에 맞는 모델을 내려받고, 완료될 때까지 기다려요. 요청 파일에 쓸 이름은 모델 목록의 정확한 이름을 복사해주세요. 태그가 다른 모델이나 다른 엔진의 모델을 같은 것으로 취급하면 요청을 처리할 노드를 찾지 못할 수 있어요.
처음에는 설치·다운로드·실행을 따로 확인하는 것이 좋아요. PC 카드가 보이는지, 엔진이 실행 중인지, 모델 다운로드가 끝났는지 순서대로 봐주세요. 모델을 명시적으로 불러와야 하는 엔진이라면 그 단계도 필요해요. 이번 예시의 MODEL_NAME은 실제 제품명이나 추천 모델이 아니라 독자가 바꿔야 할 자리 표시자예요.
3. Endpoints에서 주소와 모델 목록을 확인해요
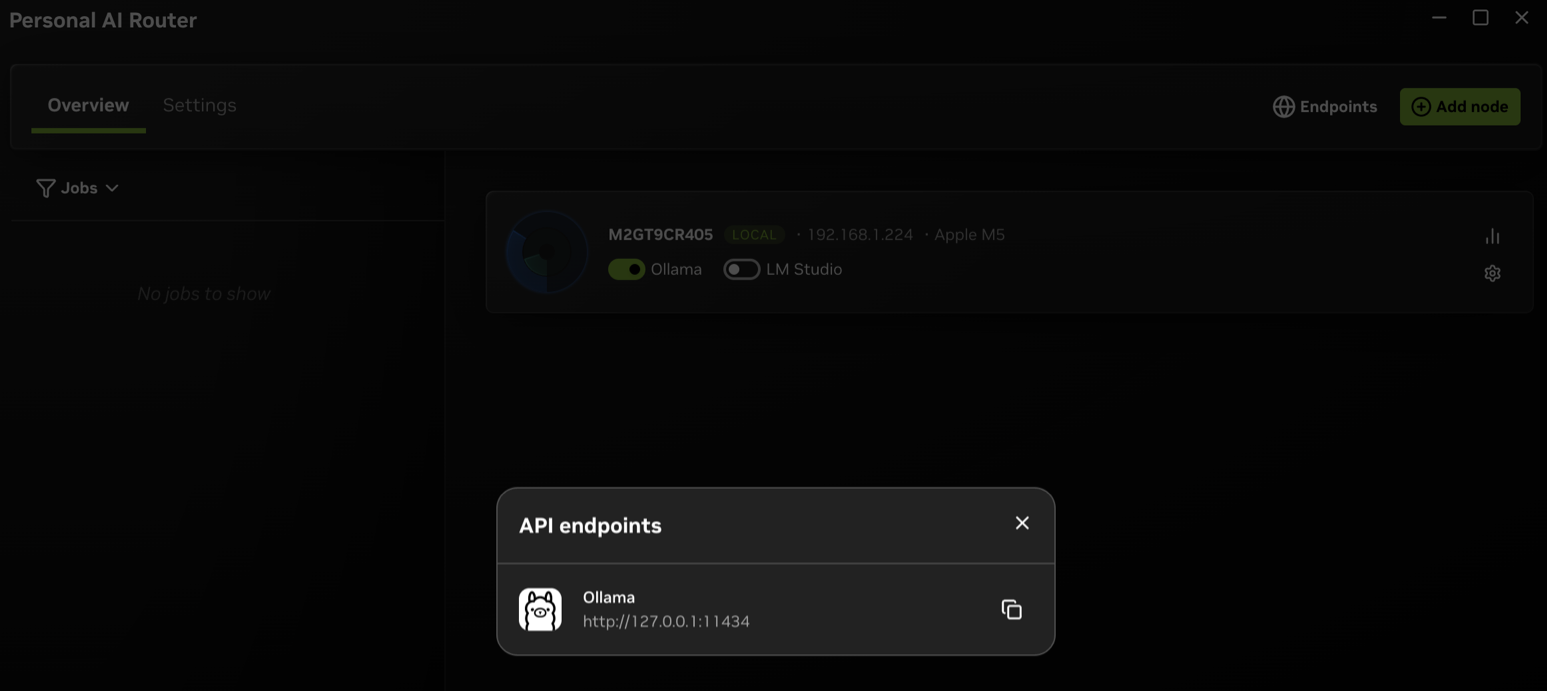
상단 Endpoints → API endpoints에서 Ollama 옆 주소를 복사해요. 기본값은 http://127.0.0.1:11434이지만 현재 창의 값이 기준이에요. 이 주소는 클라이언트가 접속하는 PAIR 프록시 주소예요. 엔진 자체의 Server 포트와 혼동하지 않도록 해주세요. 127.0.0.1은 지금 명령을 실행하는 컴퓨터 자신을 가리켜요.

터미널에서 다음 명령으로 준비된 모델 목록을 확인할 수 있어요. 주소를 변경했다면 복사한 값으로 바꿔요. Windows PowerShell에서는 명령 이름을 curl.exe로 적어주세요.
curl http://127.0.0.1:11434/v1/models예상 결과는 클러스터에서 제공할 수 있는 모델 목록이에요. 목록에 있다는 사실만으로 추론 성공까지 확인된 것은 아니지만, 주소가 응답하는지와 요청할 이름을 확인할 수 있어요. No engines are running이면 2단계로 돌아가 엔진을 시작하고, 연결 거부라면 포트와 서비스 상태를 먼저 살펴봐요.
4. 입력을 파일로 저장하고 답변을 받아요
새 폴더에 아래 내용을 UTF-8 형식의 pair-request.json으로 저장해요. MODEL_NAME을 준비한 정확한 모델 이름으로 바꿔주세요. 이 파일은 PAIR 전용 저장 형식이 아니라 다음에도 같은 입력을 보낼 수 있도록 남기는 요청 기록이에요.
{
  "model": "MODEL_NAME",
  "stream": false,
  "messages": [
    {"role": "user", "content": "Explain what a network router does in one short sentence."}
  ]
}
터미널에서 해당 폴더로 이동해 아래 한 줄을 실행해요. PowerShell이라면 역시 curl.exe를 사용해요. --data-binary 뒤의 @는 방금 저장한 파일 내용을 읽어 보내라는 뜻이고, -o는 응답을 파일로 남기는 옵션이에요.
curl http://127.0.0.1:11434/v1/chat/completions -H "Content-Type: application/json" --data-binary @pair-request.json -o pair-response.jsonpair-response.json을 텍스트 편집기로 열고 choices 안의 message.content를 찾아요. 네트워크 라우터에 대한 짧은 답변이 예상되며 정확한 문장은 모델에 따라 달라요. 오류도 JSON 파일로 저장될 수 있으므로 파일이 생겼다는 것만으로 성공이라고 판단하지 마세요. 응답을 받지 못했다면 입력 파일의 따옴표·쉼표, 모델 이름과 주소를 각각 확인해요.
5. Jobs에서 실제 처리한 PC를 확인해요
Overview → Jobs 필터에서 방금 요청의 카드를 찾고 Running on 또는 Ran on을 읽어요. Sent to만 보이면 전달 대상이 정해졌어도 아직 실행되지 않았을 수 있어요. 요청 시각과 모델 이름을 응답 파일과 함께 대조하면 다른 작업의 카드를 보고 착각하는 일을 줄일 수 있어요.
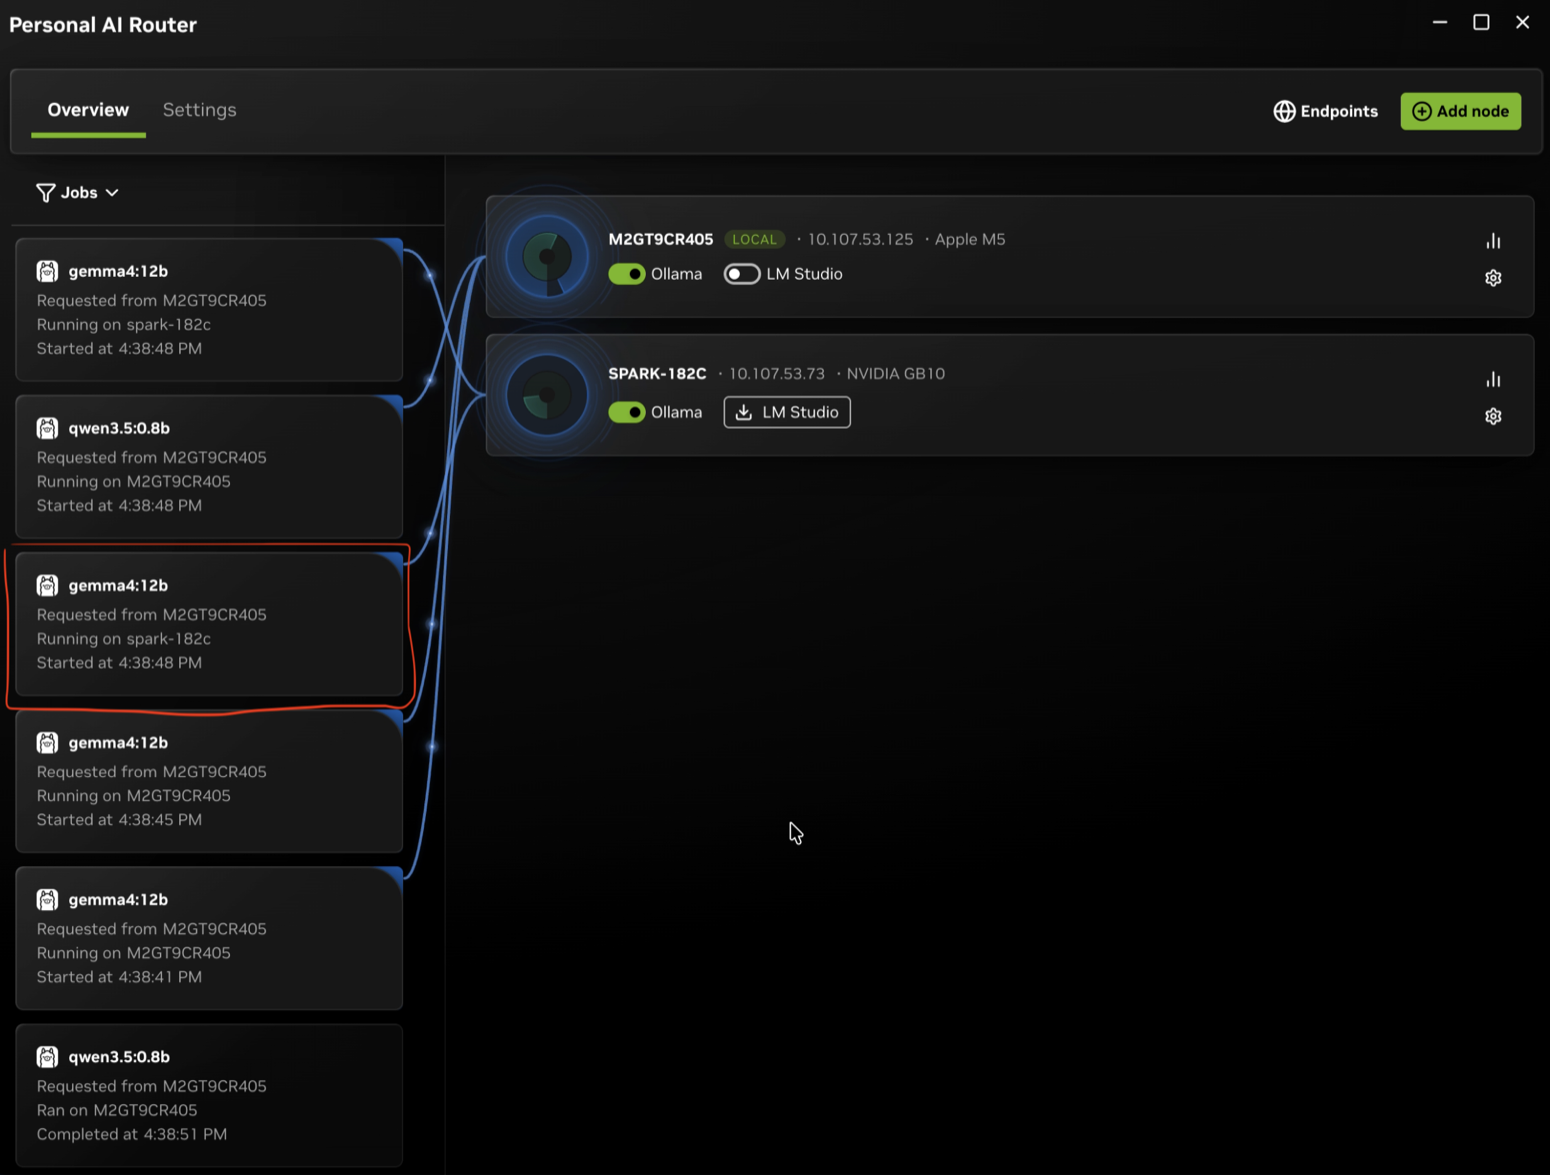

답변은 오는데 Jobs에 아무 기록도 없다면 PAIR를 거치지 않고 다른 프로그램의 같은 포트로 접속했을 가능성을 확인해야 해요. 공식 문서도 이런 증상을 별도 문제로 다뤄요. 이 단계의 완료 조건은 단순히 문장이 나온 것이 아니라, 해당 요청과 실행 위치를 짝지어 확인하는 것이에요.
6. 두 번째 PC로 전달되는지 분리해서 확인해요
두 PC에서 PAIR를 열고 첫 PC의 Add node 또는 Settings → Cluster → Available nodes to add에서 상대를 선택해요. 초대한 PC에 나온 6자리 PIN을 초대받은 PC의 Cluster invitation 창에 입력한 뒤 Connected nodes를 확인해요. 각 PC와 네트워크를 신뢰할 수 있을 때 진행해주세요.
여러 PC에 같은 모델을 준비하면 여러 요청을 분산할 후보가 늘어나지만, 한 번 보낸 요청이 꼭 원격 PC로 가는 것은 아니에요. 원격 전달만 명확히 확인하려면 공식 안내처럼 요청하는 PC에는 없고 두 번째 PC에만 있는 테스트 모델을 준비해요. 기존 모델을 지울 필요 없이 별도 모델을 골라도 돼요. 요청 파일을 복사해 그 모델 이름으로 바꾸고 첫 PC의 로컬 주소로 보내요. Jobs의 Ran on이 두 번째 PC를 가리키는지가 예상 확인 결과예요.
이 원격 확인과 여러 PC 사이의 분산 성능 비교는 다른 작업이에요. 나중에 동시 처리를 비교하려면 같은 모델을 각 후보 PC에 준비하고 독립 요청 여러 개의 실행 위치와 전체 완료 시간을 기록해요. PAIR는 한 요청을 두 PC에 쪼개지 않아요. 기본 연결 확인을 마치기 전에 처리 속도를 평가하면 모델 다운로드나 초기 적재 시간이 섞일 수 있어요.
문제가 생기면 증상을 나눠봐요
| 증상 | 먼저 확인할 항목 |
|---|---|
| 연결 거부 | Endpoints의 현재 주소와 Settings → Service |
| 502, 실행 가능한 노드 없음 | 해당 엔진 실행 여부, 노드 연결과 모델 목록 |
| 404, 모델 호출 실패 | 오래된 목록인지, 실제 모델이 준비돼 있는지 |
| 400 또는 422 | 요청 JSON 구조와 모델 이름 |
| 터미널은 되는데 웹 앱만 실패 | 해당 엔진이 웹 앱 출처를 허용하는 CORS 설정 |
| 카드나 Jobs 갱신이 멈춤 | Settings → Service에서 서비스 상태와 재시작 |
설정을 바꿀 때는 엔진 설정의 Settings → Apply와 공식 안내를 확인해요. 특히 웹 앱 접근 허용은 사용할 출처를 구체적으로 지정해야 해요. 무조건 모든 출처를 허용하는 값으로 바꾸기보다, 터미널 요청이 먼저 되는지 확인하면 브라우저 설정 문제를 분리할 수 있어요.
남겨두면 다음 시험이 쉬워지는 기록
입력 파일, 응답 파일, PAIR·엔진 버전, 모델의 정확한 이름, 요청 시각과 Jobs의 실행 PC를 같은 작업 기록으로 보관해요. 다시 시험할 때 원본 입력을 유지하고 바꾼 조건만 따로 적으면 연결 문제와 모델 결과 차이를 구분하기 쉬워요. 답변 문장의 품질, 첫 응답 시간, 여러 요청의 총 완료 시간은 각각 다른 관찰 항목이에요.
이번 안내의 완료 조건은 응답 안의 답변 확인, 해당 Jobs 기록 확인, 그리고 선택적으로 두 번째 PC의 실행 확인이에요. 문서에 적힌 예상 절차를 실제 성공 기록으로 대신하지는 않았어요. 기존 엔진 사용과 PAIR 경유의 비교에서 다음 실험에 고정할 조건을 이어서 볼 수 있어요.
참고 자료
- https://blogs.nvidia.com/blog/local-ai-rtx-spark-laptops-software-updates/
- https://github.com/NVIDIA/Personal-AI-Router/releases/tag/v1.0.0
- https://www.nvidia.com/en-us/ai-on-rtx/personal-ai-router/
- https://github.com/NVIDIA/Personal-AI-Router/blob/85f523d3624cf1596bdda6e36c28eb8ad3969737/README.md
- https://github.com/NVIDIA/Personal-AI-Router/blob/85f523d3624cf1596bdda6e36c28eb8ad3969737/docs/getting-started.mdx
- https://github.com/NVIDIA/Personal-AI-Router/blob/85f523d3624cf1596bdda6e36c28eb8ad3969737/docs/overview.mdx
- https://github.com/NVIDIA/Personal-AI-Router/blob/85f523d3624cf1596bdda6e36c28eb8ad3969737/docs/known-issues.mdx
- https://github.com/NVIDIA/Personal-AI-Router/blob/85f523d3624cf1596bdda6e36c28eb8ad3969737/docs/engine-settings.mdx
- https://api.github.com/repos/NVIDIA/Personal-AI-Router
- https://github.com/NVIDIA/Personal-AI-Router/pull/27